
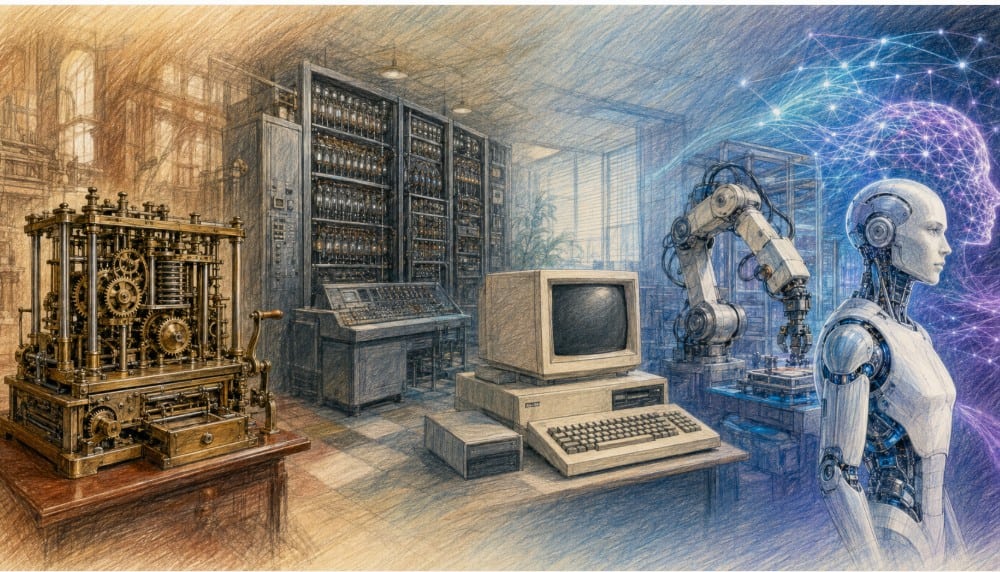
De moderne digitale wereld ontstond niet door één uitvinding, maar door een lange reeks verbeteringen in rekenmachines, elektronica, netwerken, software en gegevensverwerking. Computers werden kleiner en goedkoper, internet verbond ze wereldwijd en kunstmatige intelligentie leerde patronen herkennen. Nieuwe mogelijkheden gingen telkens samen met vragen over macht, arbeid, veiligheid, privacy en menselijke verantwoordelijkheid.
Inhoudsopgave
De computer kent niet één uitvinder
De vraag wie de computer uitvond, heeft geen eenvoudig antwoord. Het begrip computer kan slaan op een programmeerbare machine, een elektronisch apparaat, een digitaal systeem of een machine die instructies in haar geheugen bewaart. Voor iedere omschrijving bestaat een andere kandidaat. De moderne computer kwam daarom voort uit werk van wiskundigen, ingenieurs, programmeurs, overheden en bedrijven in verschillende landen.
Van mechanische berekening naar een programma
Charles Babbage ging in de jaren 1830 een stap verder met zijn ontwerp voor de Analytical Engine. De machine kreeg op papier een geheugen, een rekeneenheid en een besturing met ponskaarten, onderdelen die herkenbaar zijn in latere computers. Babbage voltooide het apparaat niet, onder meer door technische, financiële en organisatorische problemen. Zijn ontwerp maakte wel duidelijk dat één machine verschillende opdrachten kon uitvoeren wanneer de instructies veranderden.
Ada Lovelace beschreef in 1843 hoe de geplande machine een reeks berekeningen met Bernoulligetallen kon uitvoeren. Haar notities bevatten een vroeg gepubliceerd algoritme dat uitdrukkelijk voor een machine was bedoeld. Ze zag bovendien dat een programmeerbaar apparaat in beginsel ook symbolen, muziek of tekst kon verwerken, zolang die informatie volgens regels werd weergegeven. Daarmee reikte haar visie verder dan het versnellen van rekenwerk alleen.
Elektronische machines kregen vorm tijdens de oorlog
De Tweede Wereldoorlog versnelde de bouw van automatische rekenmachines, doordat grote aantallen ballistische tabellen en versleutelde berichten moesten worden verwerkt. De Duitse Z3 uit 1941 was digitaal en programmeerbaar, maar werkte met elektromechanische relais. De Britse Colossus werd vanaf 1944 ingezet voor codeanalyse en gebruikte elektronenbuizen, maar was ontworpen voor een beperkt soort opdrachten. Beide machines vertegenwoordigen daarom een ander deel van het moderne computerbegrip.
De Amerikaanse ENIAC was een elektronische, digitale machine die voor uiteenlopende numerieke berekeningen kon worden ingesteld. Het apparaat werd in 1946 publiek gepresenteerd, woog ongeveer dertig ton en bevatte bijna achttienduizend elektronenbuizen. Programmeren vergde aanvankelijk het handmatig omzetten van schakelaars en kabelverbindingen. Daardoor was de machine snel tijdens het rekenen, maar kostte het veel tijd om haar voor een nieuwe opdracht gereed te maken.
De volgende stap was het opgeslagen programma: instructies en gegevens kwamen samen in het elektronische geheugen te staan. De Manchester Baby voerde in juni 1948 een programma uit dat op deze manier was opgeslagen. Daarna werd software steeds meer een zelfstandig onderdeel van computers, los van de bedrading van één apparaat. Dat beginsel maakte algemene computers mogelijk waarop achtereenvolgens heel verschillende programma’s konden draaien.
De transistor bracht de computer buiten het laboratorium
Elektronenbuizen verbruikten veel stroom, produceerden warmte en namen veel ruimte in. De transistor, in 1947 ontwikkeld door John Bardeen, Walter Brattain en William Shockley, kon dezelfde schakelfunctie veel kleiner en betrouwbaarder uitvoeren. Eind jaren 1950 volgde de geïntegreerde schakeling, waarin meerdere elektronische onderdelen op één stukje halfgeleidermateriaal werden aangebracht. Zo konden fabrikanten steeds meer rekenkracht in een steeds kleiner apparaat onderbrengen.
De microprocessor bundelde vanaf het begin van de jaren 1970 de centrale verwerkingseenheid op één chip. Computers verschenen vervolgens in meetapparatuur, machines, kantoren en woningen. De Apple II uit 1977 en de IBM PC uit 1981 droegen bij aan de verspreiding van de personal computer, terwijl latere laptops en smartphones dezelfde ontwikkeling voortzetten. Een hedendaagse telefoon combineert rekenkracht, opslag, sensoren en netwerkverbindingen waarvoor vroeger meerdere afzonderlijke apparaten nodig waren.
Internet maakte losse computers tot een wereldwijd netwerk
Een krachtige computer blijft beperkt wanneer informatie alleen lokaal beschikbaar is. Netwerktechniek maakte het mogelijk om gegevens tussen machines te verdelen en op afstand samen te werken. Internet is daarbij de infrastructuur van gekoppelde netwerken; het World Wide Web is een dienst die daarvan gebruikmaakt. Dat onderscheid raakt gemakkelijk uit beeld, omdat webbrowsers voor veel mensen de zichtbare ingang tot internet werden.
ARPANET liet pakketgeschakelde communicatie werken
ARPANET verbond in 1969 aanvankelijk vier Amerikaanse onderzoeksinstellingen. Op 29 oktober probeerde een team van de University of California in Los Angeles het woord LOGIN naar een computer van het Stanford Research Institute te sturen. Na de letters L en O viel de verbinding uit. Het korte bericht “LO” werd zo het onbedoelde eerste teken van een netwerk dat veel groter zou worden dan de onderzoekers toen konden overzien.
Het netwerk verdeelde informatie in pakketten die afzonderlijk hun weg naar de bestemming konden vinden. Deze aanpak gebruikte verbindingen doelmatiger dan een vaste lijn die tijdens een volledige sessie bezet bleef. Onderzoekers ontwikkelden vervolgens afspraken waarmee uiteenlopende computernetwerken gegevens konden uitwisselen. De overgang van ARPANET op TCP/IP op 1 januari 1983 vormde een belangrijk moment in de ontwikkeling van het internet als netwerk van netwerken.
De opzet was verspreid: niet één centrale computer bepaalde al het verkeer. Dat maakte uitbreiding mogelijk zonder dat ieder aangesloten netwerk dezelfde hardware hoefde te gebruiken. Universiteiten, overheidsinstellingen en later commerciële aanbieders bouwden voort op open technische standaarden. E-mail, bestandsoverdracht en nieuwsgroepen bestonden al voordat het web zijn intrede deed en lieten zien dat een netwerk ook een sociale omgeving kon worden.
Het web maakte informatie eenvoudiger bereikbaar
Tim Berners-Lee stelde in maart 1989 bij CERN een systeem voor waarin documenten via hyperlinks met elkaar verbonden waren. Eind 1990 werkten de eerste webserver en browser. Het web combineerde internetverbindingen met adressen, hypertekst en een standaard voor het opvragen van documenten. Toen CERN de websoftware in 1993 vrij beschikbaar maakte, konden anderen zonder licentiedrempel servers, browsers en websites ontwikkelen.
Grafische browsers brachten in de jaren 1990 tekst en afbeeldingen samen in een gebruiksvriendelijke omgeving. Daardoor hoefde een bezoeker niet langer verschillende netwerkcommando’s te kennen. Uitgevers, winkels, overheden en particulieren gingen informatie publiceren, waarna zoekmachines nodig werden om die snel groeiende hoeveelheid te ordenen. Het web veranderde internet zo van een voornamelijk academische voorziening in een massamedium voor communicatie, handel en cultuur.
Open verbindingen kregen gesloten toegangspoorten
De voordelen van permanente verbinding gingen gepaard met nieuwe kwetsbaarheden. Persoonsgegevens konden op grote schaal worden gevolgd, gestolen of gebruikt om gedrag te voorspellen. Cyberaanvallen troffen niet alleen computers, maar ook ziekenhuizen, energievoorzieningen en overheidsdiensten. Digitale geletterdheid omvat daardoor meer dan apparaten bedienen; kennis van beveiliging, bronbeoordeling en gegevensbescherming werd onderdeel van normaal maatschappelijk functioneren.
Kunstmatige intelligentie ontwikkelde zich in golven
Kunstmatige intelligentie is geen afzonderlijke machine, maar een verzamelnaam voor methoden waarmee computers taken uitvoeren die met waarnemen, taal, voorspellen, plannen of beslissen te maken hebben. Wat in een bepaalde periode als intelligent geldt, verschuift zodra een techniek gewoon wordt. Routeplanning en automatische spellingcontrole waren ooit opvallende AI-toepassingen, maar worden inmiddels vaak als normale software beschouwd.
Van regels en symbolen naar lerende systemen
Alan Turing stelde in 1950 voor om niet te blijven steken in de abstracte vraag of machines werkelijk denken. Zijn imitatiespel onderzocht of een menselijke beoordelaar in een tekstgesprek onderscheid kon maken tussen een mens en een machine. Tijdens een onderzoeksbijeenkomst in Dartmouth in 1956 raakte de term artificial intelligence ingeburgerd. Onderzoekers verwachtten toen dat redeneren, taal en leren betrekkelijk snel in formele regels konden worden gevat.
Vroege AI werkte vooral met symbolen, logische regels en zoekprocedures. Zulke systemen konden stellingen bewijzen, eenvoudige gesprekken nabootsen en later deskundigen ondersteunen met vastgelegde kennis. Buiten hun zorgvuldig afgebakende omgeving bleken ze echter broos: alledaagse kennis, dubbelzinnigheid en onverwachte situaties waren moeilijk in regels te vangen. Perioden van hoge verwachtingen werden daarom gevolgd door bezuinigingen en teruglopende belangstelling, de zogenoemde AI-winters.
Machine learning koos een andere route. Een programmeur beschreef niet langer iedere beslisregel, maar liet een model patronen afleiden uit voorbeelden. Statistische leermethoden werden sterker door grotere gegevensverzamelingen, snellere chips en verbeterde algoritmen. Het resultaat bleef afhankelijk van menselijke keuzes over trainingsgegevens, doelen en beoordeling. Een systeem leert immers niet wat waar, rechtvaardig of wenselijk is, maar optimaliseert de maatstaf die het krijgt.
Spellen maakten vooruitgang zichtbaar
De overwinning van Deep Blue op schaakwereldkampioen Garry Kasparov in 1997 kreeg grote symbolische betekenis. De computer combineerde snelle zoekprocedures met schaakkennis en rekende enorme aantallen mogelijke stellingen door. Dat was een indrukwekkende technische prestatie, maar geen bewijs van breed menselijk denkvermogen. Deep Blue kon na de wedstrijd niet zelfstandig een gesprek voeren, een auto besturen of een nieuw spel begrijpen.
AlphaGo liet in 2016 een andere combinatie van technieken zien toen het go-speler Lee Sedol versloeg. Neurale netwerken schatten kansrijke zetten en bordposities, terwijl een zoekmethode mogelijke spelverlopen onderzocht. Het systeem kon patronen benutten die niet handmatig als volledige regels waren ingevoerd. Ook deze vaardigheid bleef aan één domein gebonden, al werd de gebruikte combinatie van leren en zoeken invloedrijk voor later onderzoek.
Generatieve AI veranderde de omgang met software
De transformerarchitectuur uit 2017 maakte het mogelijk om verbanden tussen woorden en andere gegevenselementen op grote schaal te verwerken. Grote taalmodellen worden vooraf getraind op omvangrijke tekstverzamelingen en produceren taal door waarschijnlijke vervolgstappen te berekenen. Verdere training en menselijke feedback maken hun antwoorden bruikbaarder. Sinds 2022 kregen miljoenen mensen via chatvorm toegang tot systemen die tekst, computercode, afbeeldingen, geluid en analyses kunnen voortbrengen.
Deze modellen zijn veelzijdiger dan oudere toepassingen met één vast doel. Ze kunnen samenvatten, vertalen, programmeren, informatie ordenen en een opdracht over meerdere stappen uitvoeren. Nieuwere systemen combineren verschillende soorten invoer en kunnen externe hulpmiddelen gebruiken, zoals een zoekfunctie, rekenprogramma of database. Daardoor lijkt de grens tussen een taalmodel, een digitale assistent en traditionele software minder scherp dan voorheen.
Vloeiende taal is echter geen garantie voor juistheid. Een taalmodel kan een geloofwaardige naam, gebeurtenis of bron verzinnen wanneer de berekende woordvolgorde aannemelijk klinkt. Dit verschijnsel wordt vaak hallucineren genoemd, hoewel het model zelf niets waarneemt of gelooft. Controle aan betrouwbare gegevens blijft nodig, vooral bij medische, juridische, financiële en historische informatie waar een overtuigend geformuleerde fout directe gevolgen kan hebben.
Robots brengen berekeningen naar de fysieke wereld
Een robot koppelt besturing en software aan sensoren en bewegende onderdelen. Daardoor moet het systeem niet alleen informatie verwerken, maar ook omgaan met wrijving, gewicht, obstakels, slijtage en onvoorspelbaar menselijk gedrag. Handelingen die voor mensen vanzelfsprekend lijken, zoals een slap voorwerp oppakken of een rommelige kamer doorkruisen, zijn technisch lastig. De fysieke wereld vergeeft fouten bovendien minder gemakkelijk dan een digitaal oefenprogramma.
Van Unimate naar samenwerkende robots
In 1961 ging Unimate aan het werk in een fabriek van General Motors in New Jersey. De robotarm haalde hete metalen onderdelen uit een gietmachine, een zware en gevaarlijke taak. Vroege industriële robots herhaalden vaste bewegingen achter veiligheidshekken en hadden weinig besef van hun omgeving. Hun waarde lag vooral in snelheid, kracht en herhaalbaarheid bij productieprocessen die nauwkeurig waren ingericht.
Moderne fabrieksrobots gebruiken camera’s, krachtsensoren en software om variatie beter op te vangen. Sommige modellen zijn ontworpen om in dezelfde werkruimte als mensen te functioneren en stoppen bij onverwacht contact. Toch blijft “samenwerkend” afhankelijk van de volledige installatie, de snelheid en het uitgevoerde werk. Een veilige robotarm kan nog steeds gevaar opleveren wanneer het gereedschap, het werkstuk of de omgeving niet goed is afgeschermd.
Robots buiten de fabriek blijven taakgebonden
Magazijnen gebruiken mobiele robots voor goederenvervoer, boeren zetten machines in voor melken en gewascontrole en ziekenhuizen laten robotkarren voorraden bezorgen. In woningen zijn stofzuigrobots ingeburgerd omdat hun opdracht overzichtelijk is en een fout meestal beperkte schade veroorzaakt. Zorgrobots kunnen beweging stimuleren, herinneringen geven of sociaal contact ondersteunen. Onderzoek naar hun effect laat echter geen overal geldende winst zien, terwijl bediening en onderhoud juist extra werk kunnen veroorzaken.
Zelfrijdende voertuigen tonen dezelfde spanning tussen een geslaagde proef en algemeen gebruik. Automatische systemen kunnen onder bepaalde omstandigheden sturen, remmen en navigeren, maar volledige zelfstandigheid op alle wegen en bij ieder weertype blijft een veel zwaardere opgave. Sommige voertuigen rijden zonder menselijke bestuurder binnen nauw begrensde gebieden; veel andere systemen vereisen voortdurend toezicht. De term zelfrijdend zegt daarom weinig zonder informatie over de omgeving en de resterende menselijke taak.
Automatisering vervangt taken en herschikt beroepen
Technologische verandering neemt zelden een volledig beroep in één keer over. Machines automatiseren meestal onderdelen van werk, waarna andere taken meer tijd krijgen of functies opnieuw worden ingericht. Onderzoek naar industriële robots in de Verenigde Staten vond plaatselijke druk op werkgelegenheid en lonen in sterk blootgestelde regio’s. Elders kunnen productiviteitsgroei, lagere prijzen en nieuwe activiteiten juist extra werk scheppen, waardoor de uiteindelijke verdeling per sector en regio verschilt.
Ook de eerste onderzoeken naar generatieve AI wijzen op uiteenlopende effecten. Bij 5.172 medewerkers van een klantenservice verhoogde AI-ondersteuning het aantal afgehandelde problemen per uur gemiddeld met 15 procent. Minder ervaren medewerkers profiteerden het meest, terwijl de winst bij ervaren krachten kleiner was en hun gesprekskwaliteit soms licht daalde. De uitkomst van één bedrijf voorspelt niet de hele arbeidsmarkt, maar laat wel zien dat invoering, ervaring en taakontwerp veel uitmaken.
De maatschappelijke gevolgen beginnen bij huidige systemen
Discussies over verre toekomstscenario’s kunnen afleiden van problemen die al zichtbaar zijn. AI kan bestaande vooroordelen overnemen wanneer historische gegevens ongelijke behandeling bevatten. Een model kan bovendien nauwkeurig lijken in een gemiddelde test, maar slechter werken voor groepen die in de gegevens weinig vertegenwoordigd zijn. Onafhankelijke toetsing, duidelijke gebruiksgrenzen en toezicht na invoering zijn daarom nodig naast een hoge technische score.
Menselijke controle vraagt om meer dan een noodknop
Menselijke controle werkt alleen wanneer de verantwoordelijke voldoende tijd, kennis en bevoegdheid heeft om een uitkomst tegen te spreken. Een arts die honderden automatische adviezen moet beoordelen, kan uit gewoonte op het systeem gaan vertrouwen. Hetzelfde risico bestaat bij personeelsselectie, kredietbeoordeling en overheidsbesluiten. Een mens in het proces is dus geen waarborg wanneer de organisatie afwijking ontmoedigt of niet registreert waarom een besluit tot stand kwam.
In de gezondheidszorg ondersteunen goedgekeurde AI-systemen onder meer de beoordeling van medische beelden en signalen. Ze kunnen patronen markeren en werk prioriteren, maar hun prestaties hangen af van patiëntengroep, apparatuur en werkomgeving. Klinische verantwoordelijkheid verdwijnt niet door een model toe te voegen. De veiligste toepassing is vaak een taakverdeling waarbij software meet of vergelijkt en een deskundige de bredere medische context beoordeelt.
De Europese AI-verordening deelt toepassingen in naar risico en stelt zwaardere eisen aan systemen die gezondheid, veiligheid of grondrechten kunnen raken. Bepaalde toepassingen zijn verboden, terwijl hoogrisicosystemen onder meer aan gegevensbeheer, documentatie, toezicht en controle moeten voldoen. Wetgeving kan schade beperken en verantwoordelijkheden verduidelijken, maar vervangt geen goed ontwerp. Techniek verandert sneller dan toezichtpraktijken, waardoor toetsing en handhaving voortdurend moeten worden bijgewerkt.
Digitale techniek heeft een materiële onderkant
Cloudsoftware lijkt gewichtloos, maar draait in datacentra vol chips, koeling, kabels en noodstroomvoorzieningen. De bouw en het gebruik daarvan vragen elektriciteit, water, grondstoffen en gespecialiseerde arbeid. De groei van generatieve AI verhoogt de vraag naar rekenkracht, zowel tijdens training als bij dagelijks gebruik. Efficiëntere chips kunnen het verbruik per berekening verlagen, terwijl een veel groter aantal toepassingen de totale vraag toch laat stijgen.
Ook de herkomst van gegevens en menselijke arbeid verdient aandacht. Mensen verzamelen, labelen en beoordelen trainingsmateriaal, modereren schadelijke inhoud en corrigeren modeluitvoer. Dit werk blijft vaak onzichtbaar achter het woord automatisering. Een volledige beoordeling van AI kijkt daarom niet alleen naar de kwaliteit van het model, maar ook naar arbeidsomstandigheden, grondstoffengebruik, marktmacht en de verdeling van baten en lasten.
Quantumcomputers volgen een andere rekenlogica
Een klassieke computer verwerkt bits die bij uitlezing de waarde nul of één hebben. Een quantumcomputer gebruikt qubits, waarvan de toestand door quantummechanische kansen wordt beschreven. Superpositie, verstrengeling en interferentie maken berekeningen mogelijk die geen eenvoudige kopie zijn van klassieke stappen. Dat betekent niet dat een quantumcomputer onbeperkt alle antwoorden tegelijk probeert; een bruikbaar algoritme moet gewenste uitkomsten versterken en andere mogelijkheden juist uitdoven.
Alleen bepaalde problemen kunnen voordeel opleveren
Quantumalgoritmen bieden theoretisch voordeel bij enkele soorten problemen. Het bekendste voorbeeld is het ontbinden van zeer grote getallen, waarop een deel van de huidige versleuteling steunt. Ook de simulatie van moleculen en materialen past van nature bij een quantumbeschrijving. Voor tekstverwerking, administratie, videostreaming en de meeste alledaagse software blijft een klassieke computer geschikter, goedkoper en betrouwbaarder.
Foutcorrectie bepaalt de praktische vooruitgang
Qubits reageren gemakkelijk op warmte, straling en kleine afwijkingen in de besturing. Verschillende platforms proberen dat probleem op andere manieren te beheersen, waaronder supergeleidende schakelingen, ionen en neutrale atomen. Sommige systemen werken bij temperaturen dicht bij het absolute nulpunt, terwijl andere technieken andere laboratoriumomstandigheden vereisen. Geen van deze benaderingen heeft al een brede, fouttolerante quantumcomputer opgeleverd die langdurig algemene toepassingen uitvoert.
Quantumfoutcorrectie verdeelt de informatie van één logische qubit over meerdere fysieke qubits. Experimenten die in 2025 werden gepubliceerd, lieten zien dat een grotere foutcorrigerende code de logische foutkans daadwerkelijk kon verlagen wanneer de fysieke fouten onder een drempel bleven. In 2026 werd bovendien aangetoond dat een lerend regelsysteem de afstelling tijdens foutcorrectie kon bijsturen. Dit zijn meetbare stappen, maar nog geen bewijs dat grootschalige praktische quantumcomputers op korte termijn beschikbaar zijn.
De mogelijke bedreiging voor bestaande versleuteling is wel reden om vooruit te plannen. Een voldoende grote, fouttolerante quantumcomputer zou veelgebruikte publieke-sleutelmethoden kunnen aantasten, ook al kunnen huidige apparaten dat niet. Nieuwe cryptografische methoden worden daarom ontworpen om tegen klassieke én toekomstige quantumaanvallen bestand te zijn. Voorbereiding op die overgang is verstandiger dan een exacte datum voorspellen waarop quantumhardware sterk genoeg wordt.
Algemene kunstmatige intelligentie blijft een omstreden begrip
Kunstmatige algemene intelligentie, meestal afgekort tot AGI, verwijst doorgaans naar een systeem dat kennis over veel domeinen kan toepassen en zich aan nieuwe taken kan aanpassen. Daarover bestaat geen algemeen aanvaarde definitie of test. Menselijke intelligentie omvat taal, waarneming, lichamelijke ervaring, sociale kennis, doelen en cultuur, terwijl technische maatstaven vaak slechts een deel daarvan meten. Een hoge score op veel toetsen is daardoor niet vanzelf hetzelfde als algemene intelligentie.
Brede vaardigheid is niet hetzelfde als menselijk begrip
Huidige modellen kunnen schrijven, programmeren, beelden interpreteren en hulpmiddelen bedienen, waardoor ze veel breder inzetbaar zijn dan oudere vaksystemen. Tegelijk kunnen ze eenvoudige fouten maken, context kwijtraken en gevoelig zijn voor kleine veranderingen in een opdracht. Sommige onderzoekers en technologiebedrijven gebruiken een praktische of economische definitie en spreken al van algemene vermogens. Anderen vinden dat aanpassing, begrip, betrouwbaarheid en zelfstandig leren nog te beperkt zijn om de term AGI te rechtvaardigen.
Door het ontbreken van een vaste maatstaf kan niemand neutraal vaststellen op welke dag AGI is bereikt. Voorspellingen variëren van enkele jaren tot nooit, maar zulke termijnen zijn geen experimentele uitkomsten. Eerdere AI-geschiedenis laat zien dat een sterke prestatie op één terrein gemakkelijk wordt aangezien voor een doorbraak op alle terreinen. Een zorgvuldige beoordeling beschrijft daarom concrete vaardigheden en tekortkomingen in plaats van één groot etiket te gebruiken.
De singulariteit, het idee dat een machine zichzelf steeds sneller verbetert en menselijke controle voorbijgaat, is nog speculatie. Zelfverbetering vergt meer dan nieuwe software schrijven: systemen blijven afhankelijk van chips, energie, gegevens, laboratoria, productie en menselijke organisaties. Toch verdienen geavanceerde autonome systemen aandacht voordat een theoretische eindfase wordt bereikt. Een model dat zelfstandig cyberaanvallen uitvoert, mensen manipuleert of wapens aanstuurt kan ernstige schade veroorzaken zonder dat het algemene menselijke intelligentie bezit.
Verantwoordelijkheid kan niet aan een systeem worden uitbesteed
Veilige ontwikkeling vraagt om vooraf bepaalde bevoegdheden, tests in realistische omstandigheden, registratie van incidenten en de mogelijkheid om systemen terug te trekken. Transparantie betekent daarbij niet dat iedere gebruiker miljoenen modelparameters moet begrijpen. Belangrijker is dat duidelijk blijft welke gegevens en meetmethoden zijn gebruikt, waarvoor een systeem geschikt is, wie toezicht houdt en waar een besluit kan worden aangevochten.
Conclusie
De weg van mechanische rekenmachine naar kunstmatige intelligentie bestaat uit opeenvolgende lagen. Programmeerbare machines maakten algemene berekeningen mogelijk, elektronische onderdelen brachten rekenkracht binnen handbereik en netwerken verbonden apparaten en informatie. Machine learning voegde systemen toe die patronen uit gegevens afleiden, terwijl robots digitale besturing naar de fysieke wereld brengen. Quantumcomputers onderzoeken daarnaast een andere vorm van rekenen, maar bevinden zich nog grotendeels in het laboratorium.
Geen van deze technieken is los te zien van menselijke doelen en instellingen. Computers vergroten snelheid en bereik, maar bepalen niet zelf wat eerlijk, veilig of waardevol is. De meest waarschijnlijke toekomst bestaat niet uit één plotselinge einduitvinding, maar uit verdere vermenging van software, AI, sensoren, robots en gespecialiseerde hardware. De kwaliteit van die toekomst hangt daarom evenzeer af van toezicht, verdeling en vakkennis als van technische prestaties.
Bronnen en meer informatie
- Isaacson, Walter (2014). The Innovators: How a Group of Hackers, Geniuses, and Geeks Created the Digital Revolution. Simon & Schuster. ISBN 978-1-4767-0869-0.
- Hafner, Katie en Matthew Lyon (1996). Where Wizards Stay Up Late: The Origins of the Internet. Simon & Schuster. ISBN 978-0-684-81201-4.
- Nilsson, Nils J. (2010). The Quest for Artificial Intelligence: A History of Ideas and Achievements. Cambridge University Press. ISBN 978-0-521-12293-1.
- Turing, Alan M. (1950). Computing Machinery and Intelligence. Oxford University Press. DOI 10.1093/mind/LIX.236.433.
- Silver, David et al. (2016). Mastering the Game of Go with Deep Neural Networks and Tree Search. Springer Nature. DOI 10.1038/nature16961.
- Topol, Eric J. (2019). High-performance Medicine: The Convergence of Human and Artificial Intelligence. Springer Nature. DOI 10.1038/s41591-018-0300-7.
- Bernhardt, Chris (2019). Quantum Computing for Everyone. The MIT Press. ISBN 978-0-262-03925-3.
- Acemoglu, Daron en Pascual Restrepo (2020). Robots and Jobs: Evidence from US Labor Markets. University of Chicago Press. DOI 10.1086/705716.
- Crawford, Kate (2021). Atlas of AI: Power, Politics, and the Planetary Costs of Artificial Intelligence. Yale University Press. ISBN 978-0-300-20957-0.
- Mitchell, Melanie (2024). Debates on the Nature of Artificial General Intelligence. American Association for the Advancement of Science. DOI 10.1126/science.ado7069.
- Europees Parlement en Raad van de Europese Unie (2024). Verordening (EU) 2024/1689 tot vaststelling van geharmoniseerde regels betreffende artificiële intelligentie. Publicatiebureau van de Europese Unie. ISSN 1977-0758.
- Brynjolfsson, Erik, Danielle Li en Lindsey Raymond (2025). Generative AI at Work. Oxford University Press. DOI 10.1093/qje/qjae044.
- Google Quantum AI and Collaborators (2025). Quantum Error Correction Below the Surface Code Threshold. Springer Nature. DOI 10.1038/s41586-024-08449-y.
- Sivak, Volodymyr et al. (2026). Reinforcement Learning Control of Quantum Error Correction. Springer Nature. DOI 10.1038/s41586-026-10759-2.


